[ASM·SWM] 실배포 준비(1/2) - k6를 사용하여 현재 서버의 성능을 측정해보자. (step-load, p95, p99)
[ASM·SWM] 테크리더로서의 프로젝트 설계 경험 - SDD 도입부터 브랜치 전략까지(문서 관리, AI 기반 Ticket 발행)
[ASM·SWM] 테크리더로서의 프로젝트 설계 경험 - SDD 도입부터 브랜치 전략까지(문서 관리, AI 기반 T
[ASM·SWM] SW마에스트로 17기 합격 후기! (1년의 준비 과정, 16기 탈락 그 이후) [ASM·SWM] SW마에스트로 17기 합격 후기! (1년의 준비 과정, 16기 탈락 그 이후)👋 소개안녕하세요! 대학생 개발자 주이어
blog.juyear.dev
이전 글 읽으러 가기!
👋 소개
안녕하세요! 대학생 개발자 주이어입니다.
오늘은 오랜만에 SW마에스트로 활동 글로 돌아오게 되었습니다.
최근에 저희가 개발 중인 프로젝트가 어느정도 완료가 되면서 배포를 앞두고 있습니다.
하지만 실제로 사용자가 사용하기 전에 확인해야 하는 부분과 바꿔야 하는 부분들이 있었습니다.
우선 사용자가 사용하기 위해서는 저희 서버와 전체적인 아키텍처가 몇 명의 사용자까지 감당이 가능한지 확인을 진행해야 합니다.
그래야 배포 이후 광고를 통해 갑자기 늘어나는 사용자 수에 대해서 적절하게 대처할 수 있습니다.
또한 개발의 편의성을 위해 설정해뒀던 설계나 방법들을 수정해야 합니다.
예를 들면 현재 구조에서는 테스트의 편의성을 위해 dev로 병합하면 바로 앱에 반영되는 구조로 되어있지만,
실제 배포 이후에는 검증되지 않은 코드를 사용자들이 사용하는 앱에 바로 배포하는 구조는 서비스 장애를 유발할 수 있는 위험한 구조였습니다.
그래서 오늘은 그 내용들을 정리해 보려하고, 그 중에서 k6 부하 테스트 부분부터 정리하려고 합니다.
📃 시나리오 설계
시나리오 테스트에서 중요한 점
부하 테스트를 진행할 때 중요한 부분 중 하나는 시나리오 전체를 테스트해야 한다는 점입니다.
부하 테스트에서 많이 하는 실수 중 하나가 핵심 API만 부하 테스트를 진행하여 시나리오의 최대 TPS를 측정한다는 점입니다.
하지만 이것은 제대로 된 측정이라고 볼 수 없습니다.
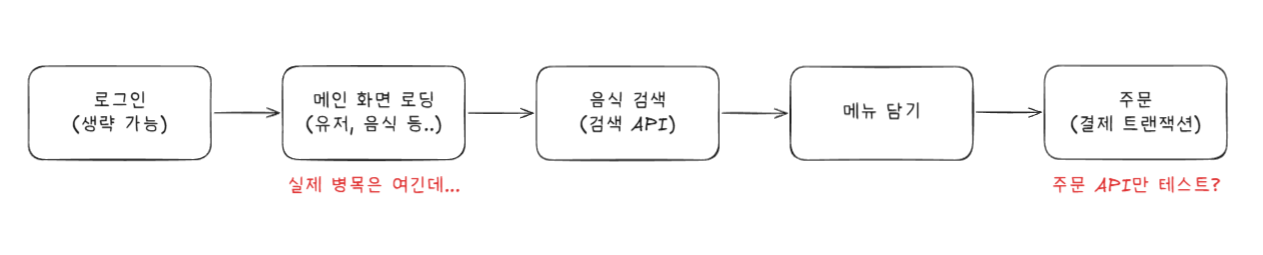
예를 들어 '배달의 민족' 앱에서 동시에 몇 명까지 음식을 주문할 수 있는지 부하 테스트를 진행한다고 생각해 보겠습니다.
주문을 동시에 몇 명까지 할 수 있는지가 궁금한 부분이니 주문 API만 테스트하면 될까요?
결론부터 말하자면, 이는 주문 시나리오 테스트가 아닌 주문 API 테스트 입니다.
실제 주문까지 가기 위해서는 그 앞에 여러 단계가 존재하고, 그 중 어디가 병목이 될지 알 수 없습니다.
사진처럼 '메인 화면 로딩'이 병목 지점이라면, 주문 API가 1000개의 동시 요청을 처리할 수 있어도 주문 시나리오에서 몇 개의 동시 요청까지 처리할 수 있는지는 알 수 없습니다.
만약 메인 화면 로딩이 동시 500개 요청까지만 처리 가능하다면, 주문 시나리오는 최대 500TPS가 되는 것입니다.
물론 주문 API만 테스트하는 것이 목적이었다면, 당연히 주문 API만 테스트할 수도 있습니다.
또한 서비스 상황에 따라서 주문에만 유독 동시 요청이 몰린다면, 오히려 앞에 단계를 같이 측정하지 않는 것이 더 적절한 테스트일 수도 있습니다.
이런 테스트 설계는 서비스 상황에 따라서 바뀔 수 있습니다.
* 참고자료 - SW마에스트로 부하 테스트 특강
E2E Test를 활용한 시나리오 설계
저는 처음에 시나리오를 어떻게 설계해야 할지 많이 고민했습니다.
그러던 중 이미 작성해둔 E2E Test를 활용할 수 있겠다는 생각이 들었습니다.
E2E Test는 실제 사용자가 서비스를 이용하는 흐름(시나리오)을 기반으로 작성되어 있기 때문에, 여기에서 서비스의 핵심 사용자 여정(User Journey)을 추출하고 이를 부하 테스트 시나리오로 재구성할 수 있지 않을까 생각했습니다.
현재 서비스에는 총 23개의 E2E Test가 존재했고, 이 중 핵심 시나리오라고 판단한 4가지를 선정하여 부하 테스트 시나리오로 만들었습니다.
이번 글에서는 그중에서도 핵심 시나리오인 '청취 시나리오'를 보여드리려고 합니다.
청취 시나리오는 사용자가 콘텐츠를 하나 선택하여 실제로 듣고, 완청한 뒤 완료 목록을 확인하는 시나리오입니다.
전체 흐름은 아래와 같습니다.
라이브러리 진입
      ↓
콘텐츠 상세 조회
      ↓
플레이어 진입
      ↓
재생 시작
      ↓
재생 위치 저장 × N
      ↓
완청 처리
      ↓
완료 목록 조회
이를 실제 API 호출 단위로 표현하면 다음과 같습니다.
GET   /users/me/library-items
GET   /users/me/library-items/resume

GET   /contents/:id
POST  /contents/:id/audio-urls
POST  /contents/:id/play

PUT   /users/me/playback-progresses/:id × N

POST  /users/me/library-items/:itemId/complete

GET   /users/me/library-items?filter=completed
여기서 중요한 것은 단순히 API를 나열하는 것이 아니라, 각 API가 사용자의 어떤 행동을 의미하는지입니다.
1. 라이브러리 진입
사용자가 앱을 실행하고 라이브러리에 진입하는 상황을 먼저 구현했습니다.
GET /users/me/library-items?filter=unplayed
GET /users/me/library-items/resume
아직 듣지 않은 콘텐츠 목록을 조회하고, 이어듣기에 필요한 정보도 조회합니다.
이후 목록에서 실제로 재생할 콘텐츠 하나를 선택합니다.
const item = list.items[0];
const contentId = item.content.id;
만약 이미 모든 콘텐츠를 완청했다면, 전체 목록에서 이미 들은 콘텐츠를 랜덤으로 다시 선택하도록 구성했습니다.
이렇게 한 이유는 부하 테스트가 특정 데이터 상태에 의존하여 중간에 종료되지 않도록 하기 위해서입니다.
2. 콘텐츠 상세 → 플레이어 진입 → 재생
콘텐츠를 선택한 이후에는 실제 플레이어에 진입하는 과정을 구현했습니다.
GET  /contents/:id
      ↓
POST /contents/:id/audio-urls
      ↓
POST /contents/:id/play
여기서 /play는 단순한 조회 API가 아닙니다.
재생 가능 여부를 판단하고, 재생 기록을 생성하며, 라이브러리 상태를 변경하는 등 실제 서비스의 상태 변경이 발생하는 핵심 트랜잭션입니다.
따라서 별도의 latency metric을 만들어 관찰했습니다.
const playLatency = new Trend('ear_play_latency', true);그리고 /play에 대해서는 별도의 threshold도 설정했습니다.
'http_req_duration{name:/contents/:id/play}': ['p(95)<700']즉, 전체 요청의 평균 latency만 보는 것이 아니라 핵심 트랜잭션의 응답시간을 별도로 관찰했습니다.
3. 재생 위치 저장
청취 시나리오에서 가장 중요하게 생각한 부분은 재생 위치 저장입니다.
5초
 ↓
PUT progress
 ↓
5초
 ↓
PUT progress
 ↓
5초
 ↓
PUT progress
 ↓
...
실제 앱에서는 사용자가 콘텐츠를 듣는 동안 일정한 간격으로 현재 재생 위치를 서버에 저장합니다.
따라서 부하 테스트에서도 이를 그대로 구현하였습니다.
for (let i = 0; i < SAVES_PER_PLAY; i++) {
  sleep(SAVE_INTERVAL_SEC);

  position += SAVE_INTERVAL_SEC;

  authPut(
    token,
    `/users/me/playback-progresses/${contentId}`,
    {
      position_sec: position,
      max_reached_sec: position,
      listened_sec_delta: SAVE_INTERVAL_SEC,
      content_version: contentVersion,
    },
  );
}
SAVE_INTERVAL_SEC = 5초
SAVES_PER_PLAY = 6회k6에서는 위와 같이 구현했고, 5초에 1번 총 6회 저장을 하는 것으로 값을 설정해 주었습니다.
따라서 한 명의 사용자가 하나의 콘텐츠를 청취하는 동안 약 30초의 재생 시간을 시뮬레이션하며, 이 과정에서 6번의 progress 저장 요청이 발생합니다.
'http_req_duration{name:/users/me/playback-progresses/:id}': ['p(95)<300']이 API를 별도로 측정한 이유는 사용자가 늘어날수록 가장 높은 빈도로 발생하는 Write 요청이고 이는 가장 큰 부하를 줄 수 있는 부분이라고 생각했기 때문입니다.
따라서 별도의 threshold를 설정했습니다.
4. 완청 처리
이후에는 콘텐츠를 완청한 상황을 구현했습니다.
서비스에서는 단순히 complete API를 호출하는 것만으로 완청을 인정하지 않고, 실제로 재생 위치가 일정 수준 이상 도달했는지를 다시 판단합니다.
95% 지점 도달
      ↓
progress 저장
      ↓
complete API
따라서 부하 테스트에서도 먼저 95% 지점까지 재생 위치를 저장한 후 완청 API를 호출하도록 구성했습니다.
const reached = Math.ceil(durationSec * 0.95);

authPut(
  token,
  `/users/me/playback-progresses/${contentId}`,
  {
    position_sec: reached,
    max_reached_sec: reached,
    ...
  },
);

authPost(
  token,
  `/users/me/library-items/${item.id}/complete`,
);
이렇게 구성함으로써 단순히 API를 순서대로 호출하는 것이 아니라 실제 서비스의 비즈니스 규칙까지 반영한 시나리오를 만들 수 있었습니다.
5. 완료 탭 확인
마지막으로 사용자가 청취를 완료한 후 완료 탭으로 이동하는 상황을 구현했습니다.
GET /users/me/library-items?filter=completed이 요청까지 완료되면 하나의 청취 여정이 종료됩니다.
따라서 하나의 VU가 수행하는 전체 흐름은 다음과 같습니다.
                    청취 여정

라이브러리 조회
      │
      ▼
콘텐츠 상세 조회
      │
      ▼
Audio URL 발급
      │
      ▼
재생 시작
      │
      ▼
Progress 저장 × 6
      │
      ▼
95% 도달
      │
      ▼
완청 처리
      │
      ▼
완료 목록 조회
이렇게 설계했을 때 만들어지는 부하
해당 시나리오의 핵심은 단순히 'VU가 많다'가 아닙니다.
한 명의 사용자가 하나의 청취 여정을 수행하면서 여러 API를 호출하기 때문에, VU가 증가하면 각 API에 발생하는 요청량도 함께 증가합니다.
특히 progress 저장은 한 번의 청취 여정에서 여러 번 발생합니다.
예를 들어 단순화해서 1,000명의 사용자가 동시에 청취한다고 가정하면...
1,000 VU
    │
    ├── library 조회
    ├── content 조회
    ├── play
    ├── progress 저장 × 6
    ├── complete
    └── completed 조회
이 중 progress 저장만 약 6,000번 발생하게 됩니다.
따라서 이 시나리오에서는 단순한 조회 부하뿐만 아니라, 다수의 사용자가 동시에 청취하면서 Write 요청이 지속적으로 발생하는 상황까지 함께 재현할 수 있었습니다.
🖥️ 모니터링 설계
이제 시나리오 설계가 끝났으니 실제로 부하 테스트를 돌려보고 metric을 분석해볼 단계입니다.
하지만 단순히 k6 대시보드 만으로는 제대로 된 metric 분석을 하기 어렵습니다.
k6 대시보드는 몇 개의 요청까지 버티는지, 실패한 것은 없는지, latency는 어느정도인지, API별 지표 등을 보여줍니다.
즉, 소프트웨어적인 병목은 파악할 수 있지만 하드웨어적인 성능은 파악하기 어렵습니다.
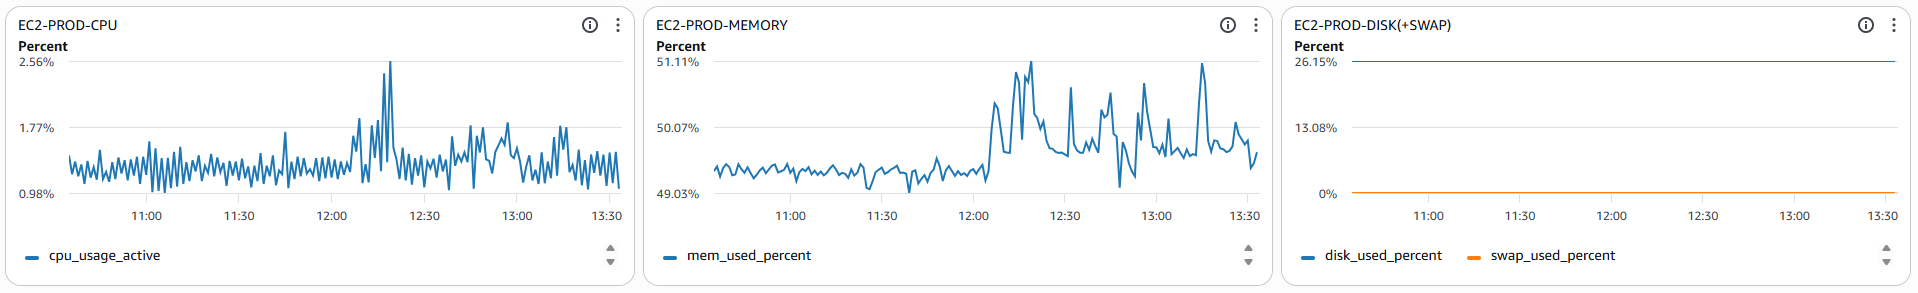
따라서 저는 AWS CloudWatch 대시보드를 구축하여 위와 같이 CPU, Memory, Disk에 대해서 모니터링을 할 수 있도록 셋팅해 주었습니다.
* CloudWatch Agent를 사용하여 구축하였습니다.
📈 부하 테스트 진행 및 결과
모니터링 설계까지 끝났고, 이제 진짜로 시나리오 부하 테스트를 진행해볼 시간입니다.
테스트 진행 방식은 step-load 방식을 사용했습니다.
해당 방식은 부하를 점차 늘려가며 어디가 한계인지를 파악하는데 유리한 테스트 방법입니다.
저희 서비스의 경우 이번이 첫 테스트이고, 기존에 측정해둔 자료가 없기 때문에 가장 기본적인 방법을 선택하였습니다.
한계의 기준은 아래와 같이 설정하였습니다.
- 요청 실패 1% 미만
- 전체 요청의 p95 < 500ms
- 전체 요청의 p99 < 1,000ms
- 재생 시작 요청의 p95 < 700ms
- 위치 저장 요청의 p95 < 300ms
- CPU < 70%
- MEMORY < 80%
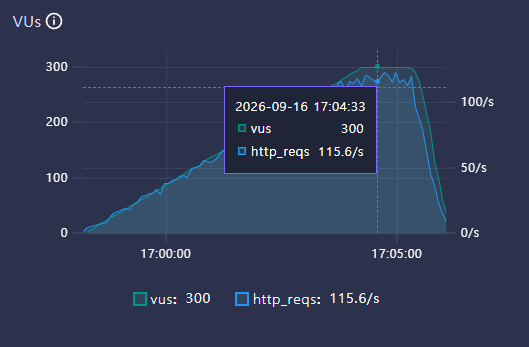
그 후 VU를 300으로 설정해 테스트를 진행해 봤습니다.
그래프를 보면 VU가 점점 늘어감에 따라 동시에 처리하는 요청도 적절하게 증가하며 부하를 잘 받아내는 것을 확인할 수 있습니다.
이외에도 오류 2건, 전체 요청의 p99가 150ms 등으로 결과가 나오면서 테스트 기준을 통과했고, TPS 110~120 사이에서는 문제가 없다는 것을 확인하였습니다.
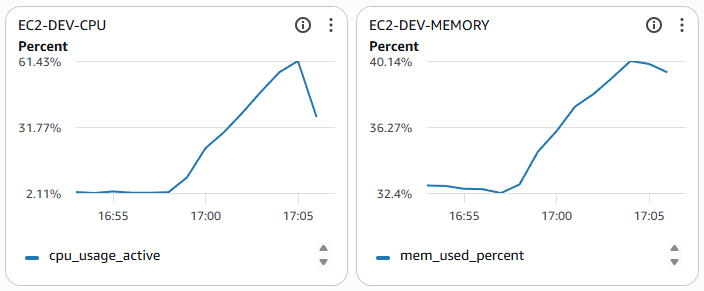
아까 설정해둔 CloudWatch 대시보드를 확인해봐도 CPU 최대 61.43%, 메모리 최대 40.14%로 위험으로 설정해둔 CPU 70%와 메모리 80% 기준도 통과했습니다.
그래서 저는 VU를 500으로 늘려 테스트를 다시 진행했습니다.
테스트를 진행하기 전 이전 테스트가 현재 테스트에 영향을 미치지 않도록 5분 정도 기다려준 후에 진행하였습니다.
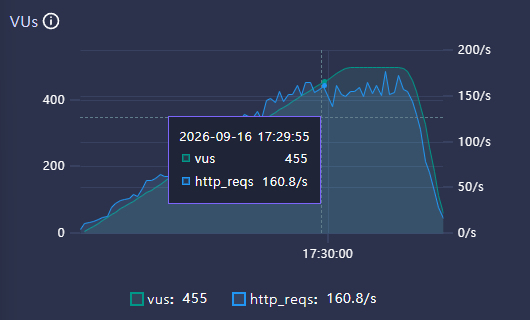
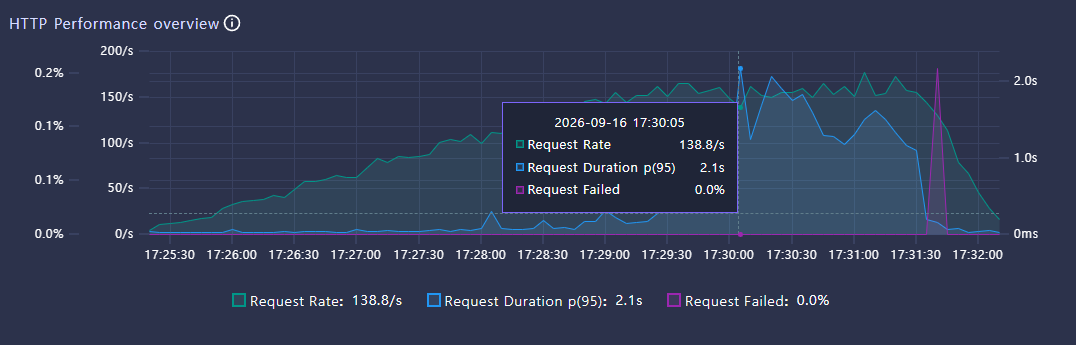
VU 500으로 진행해보니 어느정도 한계를 확인할 수 있었습니다.
VU 450 ~ 460 구간에서 그래프가 한 번 출렁이면서 그 이후로 TPS가 증가하지 않고 일정하게 유지되는 것을 알 수 있습니다.
또한 두 번째 그래프를 보면 비슷한 시점에 요청 대기 시간이 급증하며 응답 비율은 일정한 것을 알 수 있습니다.
즉, 현재 서버가 처리할 수 있는 요청보다 많은 요청이 들어오고 있다는 것을 짐작할 수 있습니다.
- 전체 요청의 p95 1.11s (통과 기준 500ms)
- 전체 요청의 p99 1.79s (통과 기준 1,000ms = 1s)
- 위치 저장 요청의 p95 529ms (통과 기준 300ms)
수치적으로 확인해봐도 세 가지 값이 통과 기준을 벗어난 것을 알 수 있습니다.
결론적으로 사용자 450 ~ 460명, TPS 150 ~ 160이 저희 서버의 한계라고 분석할 수 있고, 안정적인 운영은 약 TPS 130 정도로 생각할 수 있습니다.
서버의 한계는 파악했으니 어디가 병목인지 알아볼 차례입니다.

CloudWatch 대시보드를 확인해보니 메모리는 아까와 큰 차이가 없는 반면 CPU는 82.85%까지 차지하는 것을 알 수 있습니다.
근데 저는 여기서 한 가지 의문이 생겼습니다. 'CPU가 100%가 아닌데 왜 한계에 직면한거지?'
저는 여기서 까먹고 있던 Node.js의 작동 방식을 이해할 수 있었고, 병목 지점을 발견할 수 있었습니다.
Node는 단일 스레드 실행 방식이기 때문에 프로세스 하나가 코어 하나를 넘어서 쓸 수 없다는 특징이 있습니다.
따라서 자바스크립트 서버가 실행되고 있는 코어가 100%에 도달하면 전체 CPU는 여유가 있어도 요청을 처리하지 못 하고 응답 대기 시간이 길어지게 됩니다.
그래서 저는 SSH로 EC2에 접속하여 CPU 사용 수치를 확인해봤고, API 컨테이너의 코어 사용률이 105%로 나오는 것을 확인할 수 있었습니다.
즉, 현재 병목 지점은 자바스크립트 서버라는 것을 알 수 있고 이를 해결하기 위해서는 단순히 EC2 성능을 올리는 것 보단 로드밸런서를 사용한 다중 EC2 또는 하나의 EC2 안에 여러 서버 컨테이너를 띄우는 방법(여러 컨테이너를 띄워 여러 코어를 사용하도록 하는 방법. 다만 하나의 EC2안에서 요청을 분산하기 위한 작업이 필요함)이 효과적인 성능 개선을 할 수 있을 것 같습니다.
이렇게 결과 분석과 병목 위치까지 찾아내는 작업을 해보았습니다.
😊 마무리
이번에 부하 테스트를 진행하면서 단순히 '우리 서버가 몇 명까지 버틸 수 있는가?'를 확인하는 것 이상의 경험을 할 수 있었습니다.
처음에는 k6를 사용하여 최대 TPS를 측정하는 것에 집중했지만, 실제로 테스트를 진행해보니 어떤 시나리오를 기준으로 테스트할 것인지, 어떤 지표를 함께 봐야 하는지, 그리고 결과를 어떻게 해석할 것인지가 훨씬 중요하다는 것을 깨달았습니다.
특히 k6를 통해 응답 시간과 TPS를 확인하고, CloudWatch를 함께 확인하면서 성능 측정에서 끝나는 것이 아니라 Node.js의 실행 구조와 서버의 병목 지점까지 추적해볼 수 있었습니다.
또한 처음부터 완벽한 테스트를 설계하기보다는 실제로 부하를 조금씩 증가시키면서 이상 징후를 발견하고, 그 원인을 하나씩 찾아가는 과정에서 성능 테스트가 단순한 수치 측정이 아니라 시스템을 이해하는 과정이라는 것도 느꼈습니다.
이번 테스트를 통해 현재 서버의 한계와 개선 방향을 어느 정도 확인할 수 있었고, 다음에는 서버 구조를 개선한 뒤 동일한 시나리오로 다시 테스트하여 개선 전후의 성능을 비교해보는 작업도 진행해볼 생각입니다.
그럼 지금까지 긴 글 읽어주셔서 감사드리며, 다음에 더 좋은 글로 돌아오도록 하겠습니다.
by. 대학생 개발자 주이어
KYT CODING COMMUNITY Discord 서버에 가입하세요!
Discord에서 KYT CODING COMMUNITY 커뮤니티를 확인하세요. 26명과 어울리며 무료 음성 및 텍스트 채팅을 즐기세요.
discord.com
KYT CODING COMMUNITY 가입하기!